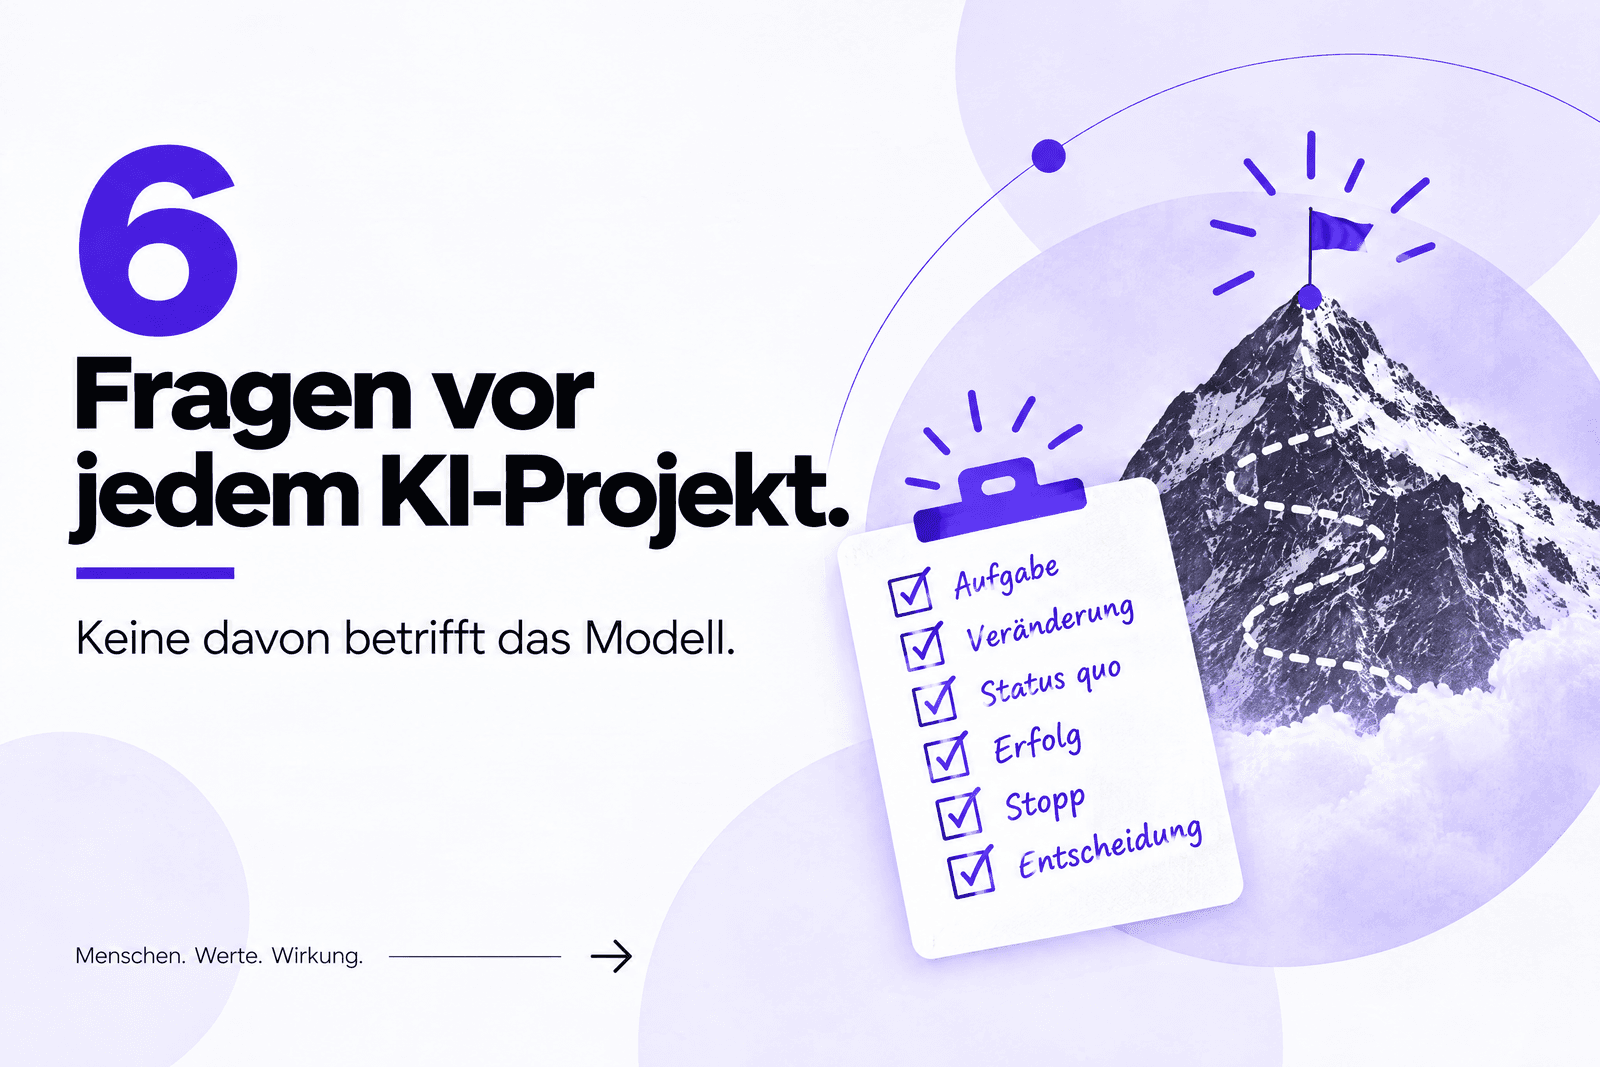
6 Fragen, die ich vor jedem KI-Projekt stelle
Vor ein paar Tagen habe ich auf LinkedIn sechs Fragen gepostet, die ich vor jedem KI-Vorhaben stelle. Keine davon betrifft das Modell. Ein Karussell hat halt pro Seite Platz für einen Gedanken. Hier kommt die lange Fassung: was jede Frage eigentlich klären soll, welche Antworten ich immer wieder höre, die nicht tragen, und wie eine brauchbare Antwort aussieht.
Die ausführliche Fassung, zum Ausfüllen
Vor ein paar Tagen habe ich auf LinkedIn sechs Fragen gepostet, die ich vor jedem KI-Vorhaben stelle. Keine davon betrifft das Modell. Ein Karussell hat halt pro Seite Platz für einen Gedanken. Hier kommt die lange Fassung: was jede Frage eigentlich klären soll, welche Antworten ich immer wieder höre, die nicht tragen, und wie eine brauchbare Antwort aussieht.
Kurz zum Hintergrund. Die Studie "The GenAI Divide" der NANDA-Initiative am Massachusetts Institute of Technology hat 2025 gemessen, ob KI-Piloten nach rund sechs Monaten einen nachweisbaren Effekt auf Gewinn und Verlust hatten. Bei den allermeisten war das nicht der Fall. Das heißt nicht, dass die Technik versagt hat. Es heißt, dass niemand zeigen konnte, was sie gebracht hat. Die sechs Fragen sollen genau das verhindern. Sie kosten euch etwa zwanzig Minuten, und danach wisst ihr, ob euer Vorhaben überhaupt entscheidbar ist.
Ein Hinweis zu den Beispielen: Sie sind zur Veranschaulichung ausgedacht und stammen nicht aus einem echten Projekt.
1. Aufgabe: Welche Aufgabe genau?
Ein Satz. Wenn ein "und" drinsteckt, sind es zwei Aufgaben.
Die typische Antwort: "Wir wollen den Kundenservice mit KI effizienter machen." Das ist ein Wunsch, keine Aufgabe. Man kann ihn nicht messen, nicht testen und nicht abbrechen.
Brauchbar ist zum Beispiel: "Eingehende E-Mails zu Adressänderungen werden automatisch der richtigen Sachbearbeitung zugeordnet." Eine Aufgabe, ein Ergebnis, eine Stelle, an der man nachsehen kann, ob es stimmt.
Warum so streng mit dem "und"? Weil zwei Aufgaben in einem System zwei Fehlerquellen bedeuten und keine saubere Messung. Wenn das Ergebnis schlecht ist, wisst ihr nicht, welcher Teil schuld war. Lieber zwei kleine Vorhaben nacheinander als ein großes, das niemand bewerten kann. Was man nicht klar beschreiben kann, kann man auch nicht verbessern.
Im Alltag gilt dasselbe. "KI soll mir im Haushalt helfen" führt zu einem Abo, das nach drei Wochen einschläft. "KI plant mir aus dem, was im Kühlschrank ist, drei Abendessen für die Woche" kann man ausprobieren und bewerten.
2. Veränderung: Was soll sich verändern?
Eine Kennzahl reicht. Etwas, das man zählen kann: Bearbeitungszeit pro Vorgang, Anteil falsch zugeordneter Fälle, Anzahl der Rückfragen, Durchlaufzeit bis zur Antwort an den Kunden.
Die typische Antwort: "Weniger Aufwand, schneller, besser." Das klingt gut, aber am Ende diskutiert ihr damit über Bauchgefühl. Genauso weich ist "die Mitarbeitenden sollen zufriedener sein". Kann ein berechtigtes Ziel sein, taugt aber nicht als alleiniges Maß, weil sich Arbeit mit KI anders anfühlt, als sie sich rechnet. Die METR-Studie von 2025 hat genau diese Lücke gezeigt: Erfahrene Entwickler schätzten sich mit KI schneller ein und waren gemessen langsamer.
Eine gute Antwort nimmt eine Zahl, die es heute schon gibt oder die sich leicht erheben lässt, und bleibt bei der einen. Wer fünf Kennzahlen gleichzeitig verfolgt, findet am Ende immer eine, die gestiegen ist.
3. Status quo: Wie sieht es heute aus?
Das ist die Frage, an der es bei fast allen Vorhaben hakt. Und die, die am meisten bringt. Drei Unterfragen reichen: Wie lange dauert es? Wer ist beteiligt? Wie oft geht etwas schief?
Die typische Antwort: "Das wissen wir ungefähr." Ungefähr reicht nicht, weil ihr in sechs Monaten gegen genau diese Zahl antreten müsst. Ohne Ausgangswert kann niemand sagen, ob der Pilot etwas gebracht hat.
So kommt ihr zu einer Ausgangszahl, ohne ein Messprojekt aufzusetzen: Zwei Wochen lang führt das Team eine einfache Strichliste. Wie viele Fälle, wie lange pro Fall, wer war beteiligt, wie viele mussten nachbearbeitet werden. Oder ihr nehmt eine Stichprobe aus dem Ticketsystem und zählt nach. Das ist nicht perfekt, aber es ist ein Vorher. Erst messen, dann verbessern.
Dieser Schritt hat einen zweiten Nutzen, der oft übersehen wird. Manchmal zeigt schon die Strichliste, dass das eigentliche Problem woanders liegt. Dann spart ihr euch den Piloten.
4. Erfolg: Ab wann ist es gut genug?
Erfolg ist kein Gefühl am Ende, sondern eine Zahl am Anfang. Ein konkreter Schwellenwert, hergeleitet vom Ist-Zustand, nicht vom Wunsch.
Die typische Antwort: "Es soll deutlich besser werden." Deutlich ist keine Zahl. Das Gegenstück ist genauso unbrauchbar: "99 Prozent Genauigkeit", ohne dass jemand weiß, wo man heute steht.
Brauchbar ist zum Beispiel: "Heute brauchen wir im Schnitt zwölf Stunden, bis eine Anfrage erledigt ist. Wenn es mit KI unter vier Stunden liegt und die Fehlerquote nicht steigt, rollen wir aus." Der Wert bezieht sich auf Frage 3, er ist erreichbar gedacht, und er sagt gleichzeitig, was nicht schlechter werden darf.
Ein technischer Hinweis dazu: KI-Systeme liefern auf dieselbe Eingabe nicht immer dieselbe Ausgabe. Legt deshalb lieber ein Band fest ("zwischen x und y") als einen exakten Punkt, und messt mehr als einmal.
5. Stopp: Ab wann hören wir auf?
Eine konkrete Bedingung mit einem konkreten Datum.
Das ist die unbequemste Frage. Eine Abbruchbedingung am ersten Tag aufzuschreiben fühlt sich an, als würde man schon vom Scheitern reden. Genau deshalb macht es fast niemand. Und genau deshalb sterben so viele Projekte still, statt entschieden zu werden. Der Marktforscher Gartner hat im Juni 2025 prognostiziert, dass über 40 Prozent der Projekte mit agentischer KI bis Ende 2027 abgebrochen werden. Abgebrochen wird also sowieso. Die Frage ist nur, ob nach drei oder nach fünfzehn Monaten.
Die typische Antwort: "Das sehen wir dann." Übersetzt heißt das: Niemand wird den Stecker ziehen, und die Lizenzen laufen weiter, bis beim Aufräumen jemand darüber stolpert.
Brauchbar ist zum Beispiel: "Wenn wir am 31. März nicht unter sechs Stunden liegen, stoppen wir den Piloten und schreiben auf, was wir gelernt haben." Ein guter Pilot muss auch sterben dürfen. Ein gestoppter Pilot mit sauberer Auswertung ist mehr wert als ein laufender, bei dem niemand weiß, ob er etwas bringt.
6. Entscheidung: Wer entscheidet?
Eine Person mit Namen. Nicht "das Team", nicht "der Lenkungskreis".
Die typische Antwort ist genau das: "Das entscheidet der Lenkungskreis." Ein Gremium kann beraten. Entscheiden muss jemand, der am Stichtag sagt: weitermachen, anpassen oder stoppen. Wenn diese Person das Budget nicht anhalten kann, ist sie nicht die richtige.
Diese Frage hängt direkt an den anderen. Ohne Namen wird die Erfolgsschwelle aus Frage 4 nicht eingefordert und der Stopp aus Frage 5 nicht gezogen. Sie ist der Grund, warum die ersten fünf Fragen am Ende tatsächlich etwas bewirken.
Experiment oder Demo
Wenn ihr alle sechs beantworten könnt, habt ihr ein Experiment, aus dem ihr etwas lernt. Wenn nicht, habt ihr wahrscheinlich eine Demo.
Ich stelle diese Fragen nicht, weil ich Formulare mag. Sondern weil ich zu oft gesehen habe, wie ein Vorhaben mit einer tollen Demo anfängt und ein halbes Jahr später niemand mehr sagen kann, ob es sich gelohnt hat.
Mit Technik hat das wenig zu tun. Darum geht es mir bei der Digitalen Renaissance: Organisationen, die mit Technologie lernen, statt sie nur auszuprobieren. Lernen braucht Maßstäbe und Menschen, die dafür geradestehen. Die sechs Fragen sind im Grunde nichts anderes als das, auf eine Seite gebracht.
Die Vorlage zum Kopieren
Legt das für euer nächstes Vorhaben einmal an. Wenn eine Zeile leer bleibt, ist das eure nächste Aufgabe, nicht der Start des Piloten.

Was ihr heute tun könnt
Nehmt euer aktuelles KI-Vorhaben und beantwortet nur Frage 3. Wenn ihr die Zahl nicht in fünf Minuten habt, wisst ihr, was diese Woche zu tun ist. Und ihr seid damit in bester Gesellschaft.
Und falls ihr mögt, schreibt mir, an welcher der sechs Fragen es bei euch hängt. Ich sammle das.
Quellen
- MIT NANDA-Initiative, "The GenAI Divide: State of AI in Business 2025" (Sommer 2025). Erfolgsdefinition: messbarer Effekt auf Gewinn und Verlust innerhalb von rund sechs Monaten.
- Gartner, Pressemitteilung (Juni 2025): über 40 Prozent der agentischen KI-Projekte werden bis Ende 2027 abgebrochen.
- METR, "Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity" (Juli 2025, arXiv 2507.09089).
- Zur fehlenden Reproduzierbarkeit von KI-Ausgaben: Horace He / Thinking Machines Lab, "Defeating Nondeterminism in LLM Inference" (September 2025).
KI-Realitätscheck 1. bis 14. Juni 2026: Was sich wirklich bewegt hat
Die Halbwertszeit einer KI-Schlagzeile liegt weiter bei etwa 48 Stunden. In den ersten zwei Juni-Wochen wurde aus "der Bundestag verabschiedet ein Durchführungsgesetz" ein "Deutschland reguliert KI scharf", aus einem freiwilligen Verhaltenskodex eine "Pflicht zum Wasserzeichen", und aus einer Exportkontroll-Anordnung ein "Anthropic schaltet Claude ab".
KI-Realitätscheck 2026: Was zwischen April und Juni wirklich passiert ist (und was davon nur Lärm war)
Die Halbwertszeit einer KI-Schlagzeile liegt bei ungefähr 48 Stunden. In dieser Zeitspanne wird aus "Microsoft schränkt intern ein Tool ein" ein "Microsoft wirft Claude raus", aus "ein Automatisierungstool verdoppelt seinen Wert" ein "n8n ist tot", und aus einer verschobenen Frist ein "die EU kippt das KI-Gesetz". Wer beruflich mit künstlicher Intelligenz arbeitet, steht damit vor einem doppelten Problem: Man muss nicht nur die Entwicklungen kennen, sondern auch laufend zwischen Signal und Lärm unterscheiden.
Digitale Renaissance im Fokus: Von der Vision zur Bewegung (Mission) - ein Aufruf zum gemeinsamen Handeln!
Die Digitale Renaissance ist eine solche Idee – geboren aus der Erkenntnis, dass wir an einem historischen Wendepunkt stehen. Der Wendepunkt kann auch ein Scheidepunkt zwischen positiven und weniger positiven Zukunftsszenarien sein.